AI 智能体的未来,是模型能够无缝协同数百乃至数千种工具。一个集成 Git 操作、文件管理、包管理器、测试框架和部署管道的 IDE 助手。一个同时连接 Slack、GitHub、Google Drive、Jira、公司数据库以及数十个 MCP 服务器的运维协调器。
要构建高效的智能体,它们需要能够处理无限的工具库,而不是将所有定义预先塞入上下文。我们关于在 MCP 中使用代码执行的博客文章曾讨论过,在智能体读取请求之前,工具结果和定义有时会消耗超过 5 万个标记。智能体应当按需发现和加载工具,仅保留与当前任务相关的内容。
智能体还需要具备从代码调用工具的能力。使用自然语言工具调用时,每次调用都需要完整的推理过程,无论中间结果是否有用都会堆积在上下文中。代码天然适合编排逻辑,例如循环、条件判断和数据转换。智能体需要根据当前任务灵活选择代码执行与推理调用。
智能体还需要从示例中学习正确的工具使用方法,而不仅仅是依赖模式定义。JSON 模式定义了结构上的有效性,但无法表达使用模式:何时包含可选参数、哪些组合具有实际意义,或者您的 API 期望遵循何种约定。
今天,我们发布三项功能来实现这一目标:
- 工具搜索工具,使 Claude 能够使用搜索工具访问数千种工具,同时不会占用其上下文窗口
- 程序化工具调用,允许 Claude 在代码执行环境中调用工具,从而减少对模型上下文窗口的影响
- 工具使用示例,为展示如何有效使用特定工具提供了通用标准
在内部测试中,我们发现这些功能帮助我们构建了传统工具使用模式无法实现的项目。例如,Claude for Excel 利用程序化工具调用功能,能够读取和修改包含数千行数据的电子表格,同时不会超出模型的上下文窗口容量。
根据我们的经验,我们相信这些功能为您利用 Claude 构建应用开启了新的可能性。
工具搜索工具
挑战
MCP 工具定义提供了重要的上下文,但随着连接的服务端增多,这些令牌会不断累积。以五个服务端的设置为例:
- GitHub:35 个工具(约 26K token)
- Slack:11 个工具(约 21K token)
- Sentry:5 个工具(约 3K token)
- Grafana:5 个工具(约 3K token)
- Splunk:2 个工具(约 2K token)
这意味着在对话开始前,就有 58 个工具消耗了约 5.5 万个token。如果再添加像 Jira 这样的服务器(仅它自己就使用了约 1.7 万个token),你很快就会接近超过 10 万个token的开销。在 Anthropic,我们曾观察到工具定义在优化前消耗了 13.4 万个token。
但token成本并非唯一问题。最常见的故障是工具选择错误和参数不正确,尤其是当工具名称相似时,比如 notification-send-user 与 notification-send-channel 。
我们的解决方案
工具搜索工具不会预先加载所有工具定义,而是按需发现工具。Claude 只会看到当前任务实际需要的工具。
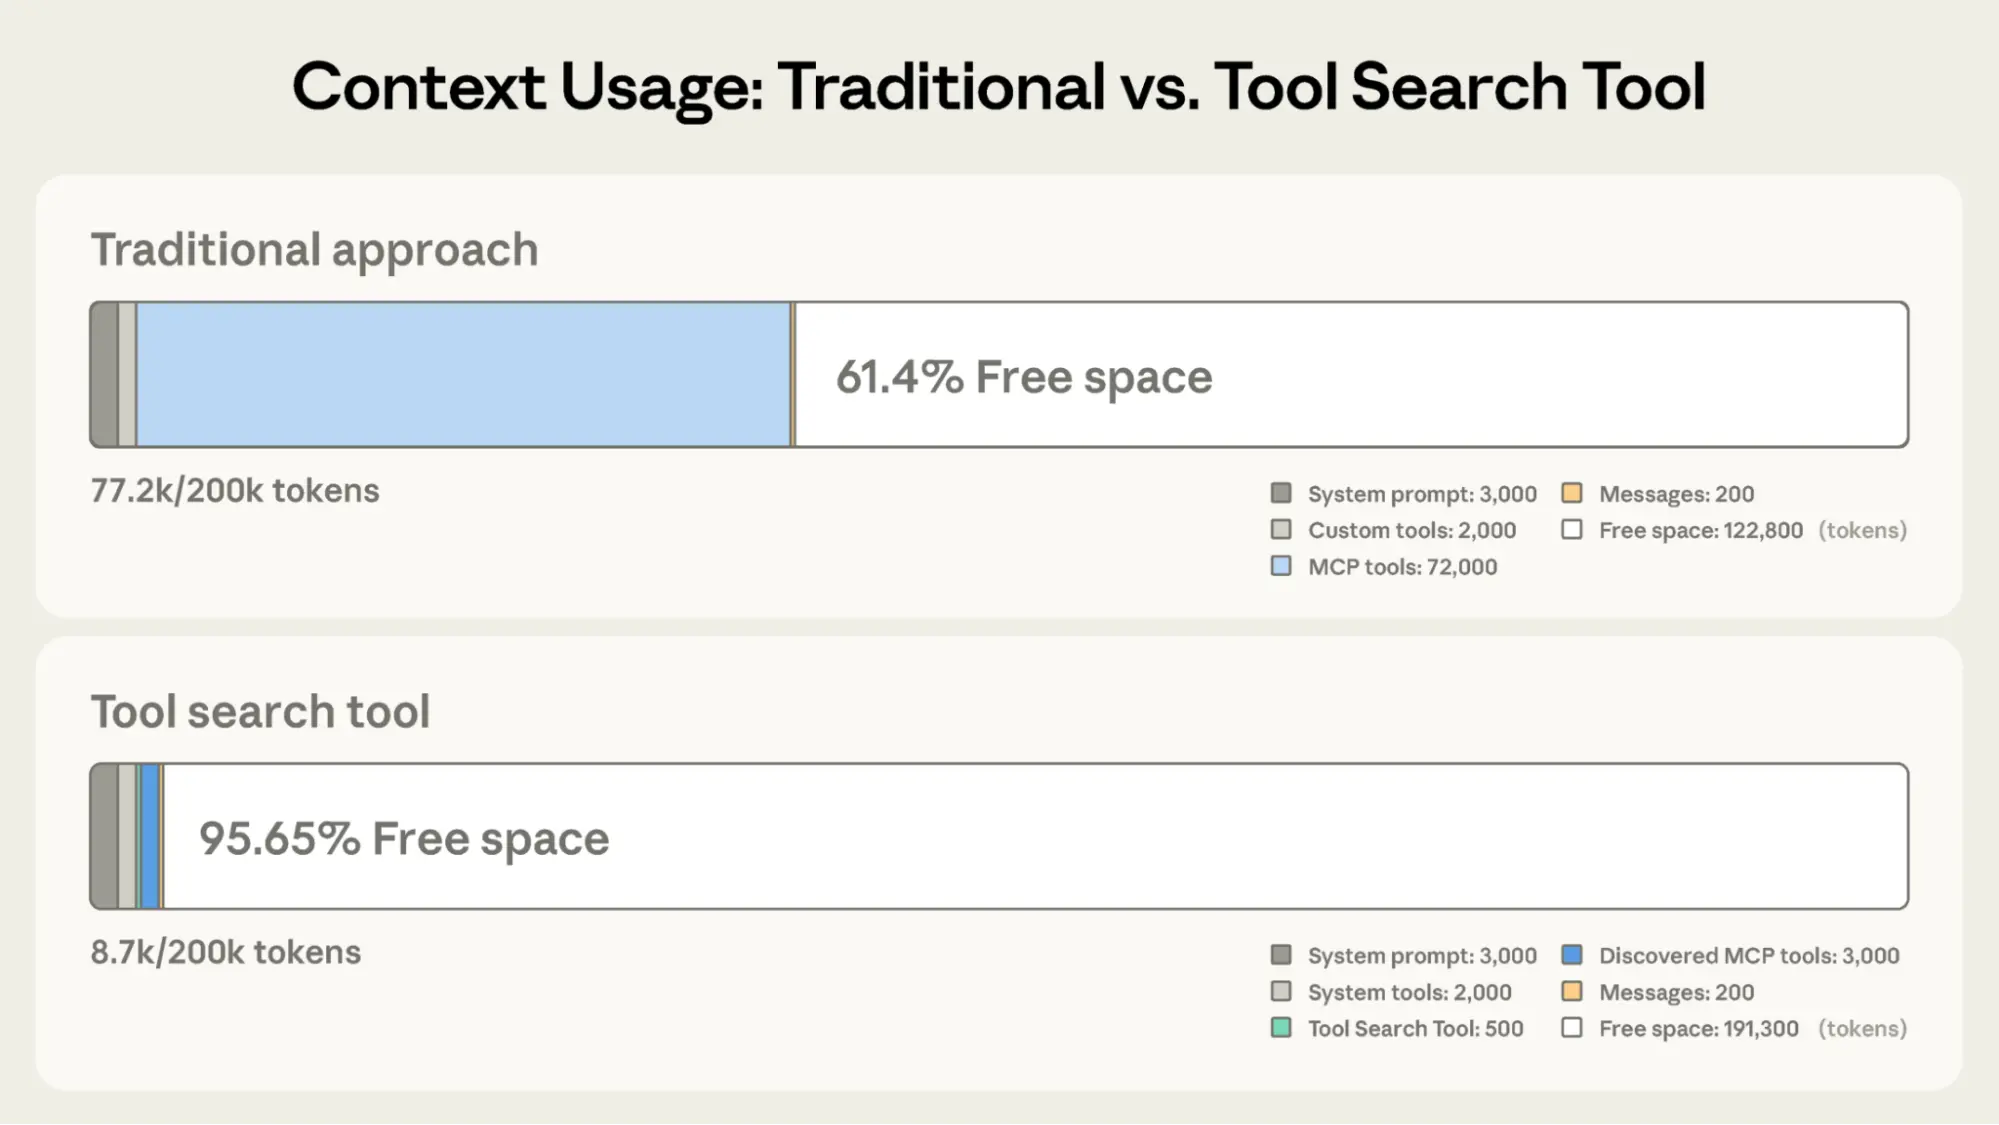
传统方法:
- 所有工具定义需预先加载(50 多个 MCP 工具约占用 72K token)
- 对话历史记录和系统提示需竞争剩余空间
- 在开始任何工作之前,总上下文消耗量:约 77K 个token
使用工具搜索工具时:
- 仅预先加载工具搜索工具(约 500 个token)
- 按需发现所需工具(3-5 个相关工具,约 3K 个token)
- 总上下文消耗:约 8.7K tokens,保留 95%的上下文窗口
这表示在保持访问完整工具库的同时,token 使用量减少了 85%。内部测试显示,在使用大型工具库时,MCP 评估的准确性有显著提升。启用工具搜索工具后,Opus 4 的准确率从 49%提升至 74%,Opus 4.5 则从 79.5%提升至 88.1%。
工具搜索工具的工作原理
工具搜索工具让 Claude 能够动态发现工具,而不是预先加载所有定义。您将所有工具定义提供给 API,但使用 defer_loading: true 标记工具,使其可按需发现。延迟加载的工具最初不会载入 Claude 的上下文。Claude 仅能看到工具搜索工具本身以及带有 defer_loading: false 标记的工具(您最关键、最常用的工具)。
当 Claude 需要特定功能时,它会搜索相关工具。工具搜索工具会返回匹配工具的引用,这些引用会在 Claude 的上下文中扩展为完整定义。
例如,如果 Claude 需要与 GitHub 交互,它会搜索"github",此时仅加载 github.createPullRequest 和 github.listIssues 工具——而不会加载您其他 50 多个来自 Slack、Jira 和 Google Drive 的工具。
通过这种方式,Claude 既能访问您的完整工具库,又只需为实际使用的工具支付 token 成本。
提示缓存说明:工具搜索工具不会破坏提示缓存,因为延迟加载的工具完全不会包含在初始提示中。它们仅在 Claude 搜索后才被添加上下文,因此您的系统提示和核心工具定义仍可被缓存。
实现方法:
{
  "tools": [
    // Include a tool search tool (regex, BM25, or custom)
    {"type": "tool_search_tool_regex_20251119", "name": "tool_search_tool_regex"},

    // Mark tools for on-demand discovery
    {
      "name": "github.createPullRequest",
      "description": "Create a pull request",
      "input_schema": {...},
      "defer_loading": true
    }
    // ... hundreds more deferred tools with defer_loading: true
  ]
}
对于 MCP 服务器,您可以在保持特定高频使用工具加载的同时,推迟加载整个服务器:
{
  "type": "mcp_toolset",
  "mcp_server_name": "google-drive",
  "default_config": {"defer_loading": true}, # defer loading the entire server
  "configs": {
    "search_files": {
"defer_loading": false
    }  // Keep most used tool loaded
  }
}
Claude 开发者平台默认提供基于正则表达式和 BM25 的搜索工具,同时您也可以通过嵌入技术或其他策略实现自定义搜索工具。
何时使用工具搜索工具
与任何架构决策一样,启用工具搜索工具也涉及权衡取舍。该功能在工具调用前增加了搜索步骤,因此当节省的上下文和准确性的提升超过额外延迟时,才能实现最佳投资回报率。
在以下情况下使用:
- 工具定义消耗超过 1 万个token
- 遇到工具选择准确性问题
- 使用多个服务器构建 MCP 驱动的系统
- 10+ 种工具可用
在以下情况下效果不佳:
- 工具库规模较小(少于 10 个工具)
- 所有工具在每次会话中均频繁使用
- 工具定义较为简洁
程序化工具调用
随着工作流程日益复杂,传统工具调用方式会引发两个根本性问题:
-
中间结果导致上下文污染:当 Claude 分析 10MB 日志文件以查找错误模式时,整个文件都会进入其上下文窗口,即使 Claude 仅需要错误频率的摘要。当跨多个数据表获取客户信息时,每条记录无论相关与否都会在上下文中累积。这些中间结果消耗大量令牌额度,并可能将重要信息完全挤出上下文窗口。
-
推理开销与人工整合:每次工具调用都需要完整的模型推理过程。在接收结果后,Claude 必须通过自然语言处理来"肉眼"筛选数据、提取相关信息、推理各片段间的关联性并决定后续操作。一个包含五个工具的工作流程意味着需要进行五次推理,外加 Claude 解析每个结果、比对数值并整合结论。这种方式既低效又容易出错。
我们的解决方案
程序化工具调用使 Claude 能够通过代码编排工具,而非通过单独的 API 往返调用。Claude 不再需要逐个请求工具并将每个结果返回至其上下文,而是编写能够调用多个工具、处理输出结果并控制实际进入其上下文窗口信息的代码。
Claude 擅长编写代码,通过让其用 Python 表达编排逻辑而非通过自然语言工具调用,您将获得更可靠、更精确的控制流程。循环、条件判断、数据转换和错误处理都在代码中明确体现,而非隐含在 Claude 的推理过程中。
示例:预算合规性检查
考虑一个常见的业务任务:“哪些团队成员超出了第三季度的差旅预算?”
您可以使用以下三种工具:
get_team_members(department)- 返回包含 ID 和级别的团队成员列表get_expenses(user_id, quarter)- 返回用户的费用明细项目get_budget_by_level(level)- 返回员工级别的预算限制
传统方法:
- 获取团队成员 → 20 人
- 针对每位成员,获取其第三季度支出 → 20 次工具调用,每次返回 50-100 条明细(航班、酒店、餐饮、收据)
- 按员工级别获取预算限制
- 所有这些内容都会进入 Claude 的上下文:2000 多条费用明细(超过 50KB)
- Claude 手动汇总每个人的费用,查找他们的预算,将费用与预算限额进行比较
- 需要更多次与模型的往返交互,消耗大量上下文
编程式工具调用:
Claude 不再让每个工具的结果直接返回给它,而是编写一个 Python 脚本来编排整个工作流程。该脚本在代码执行工具(一个沙盒环境)中运行,当需要从你的工具获取结果时会暂停。当你通过 API 返回工具结果时,它们由脚本处理而非模型直接使用。脚本继续执行,Claude 只看到最终输出。
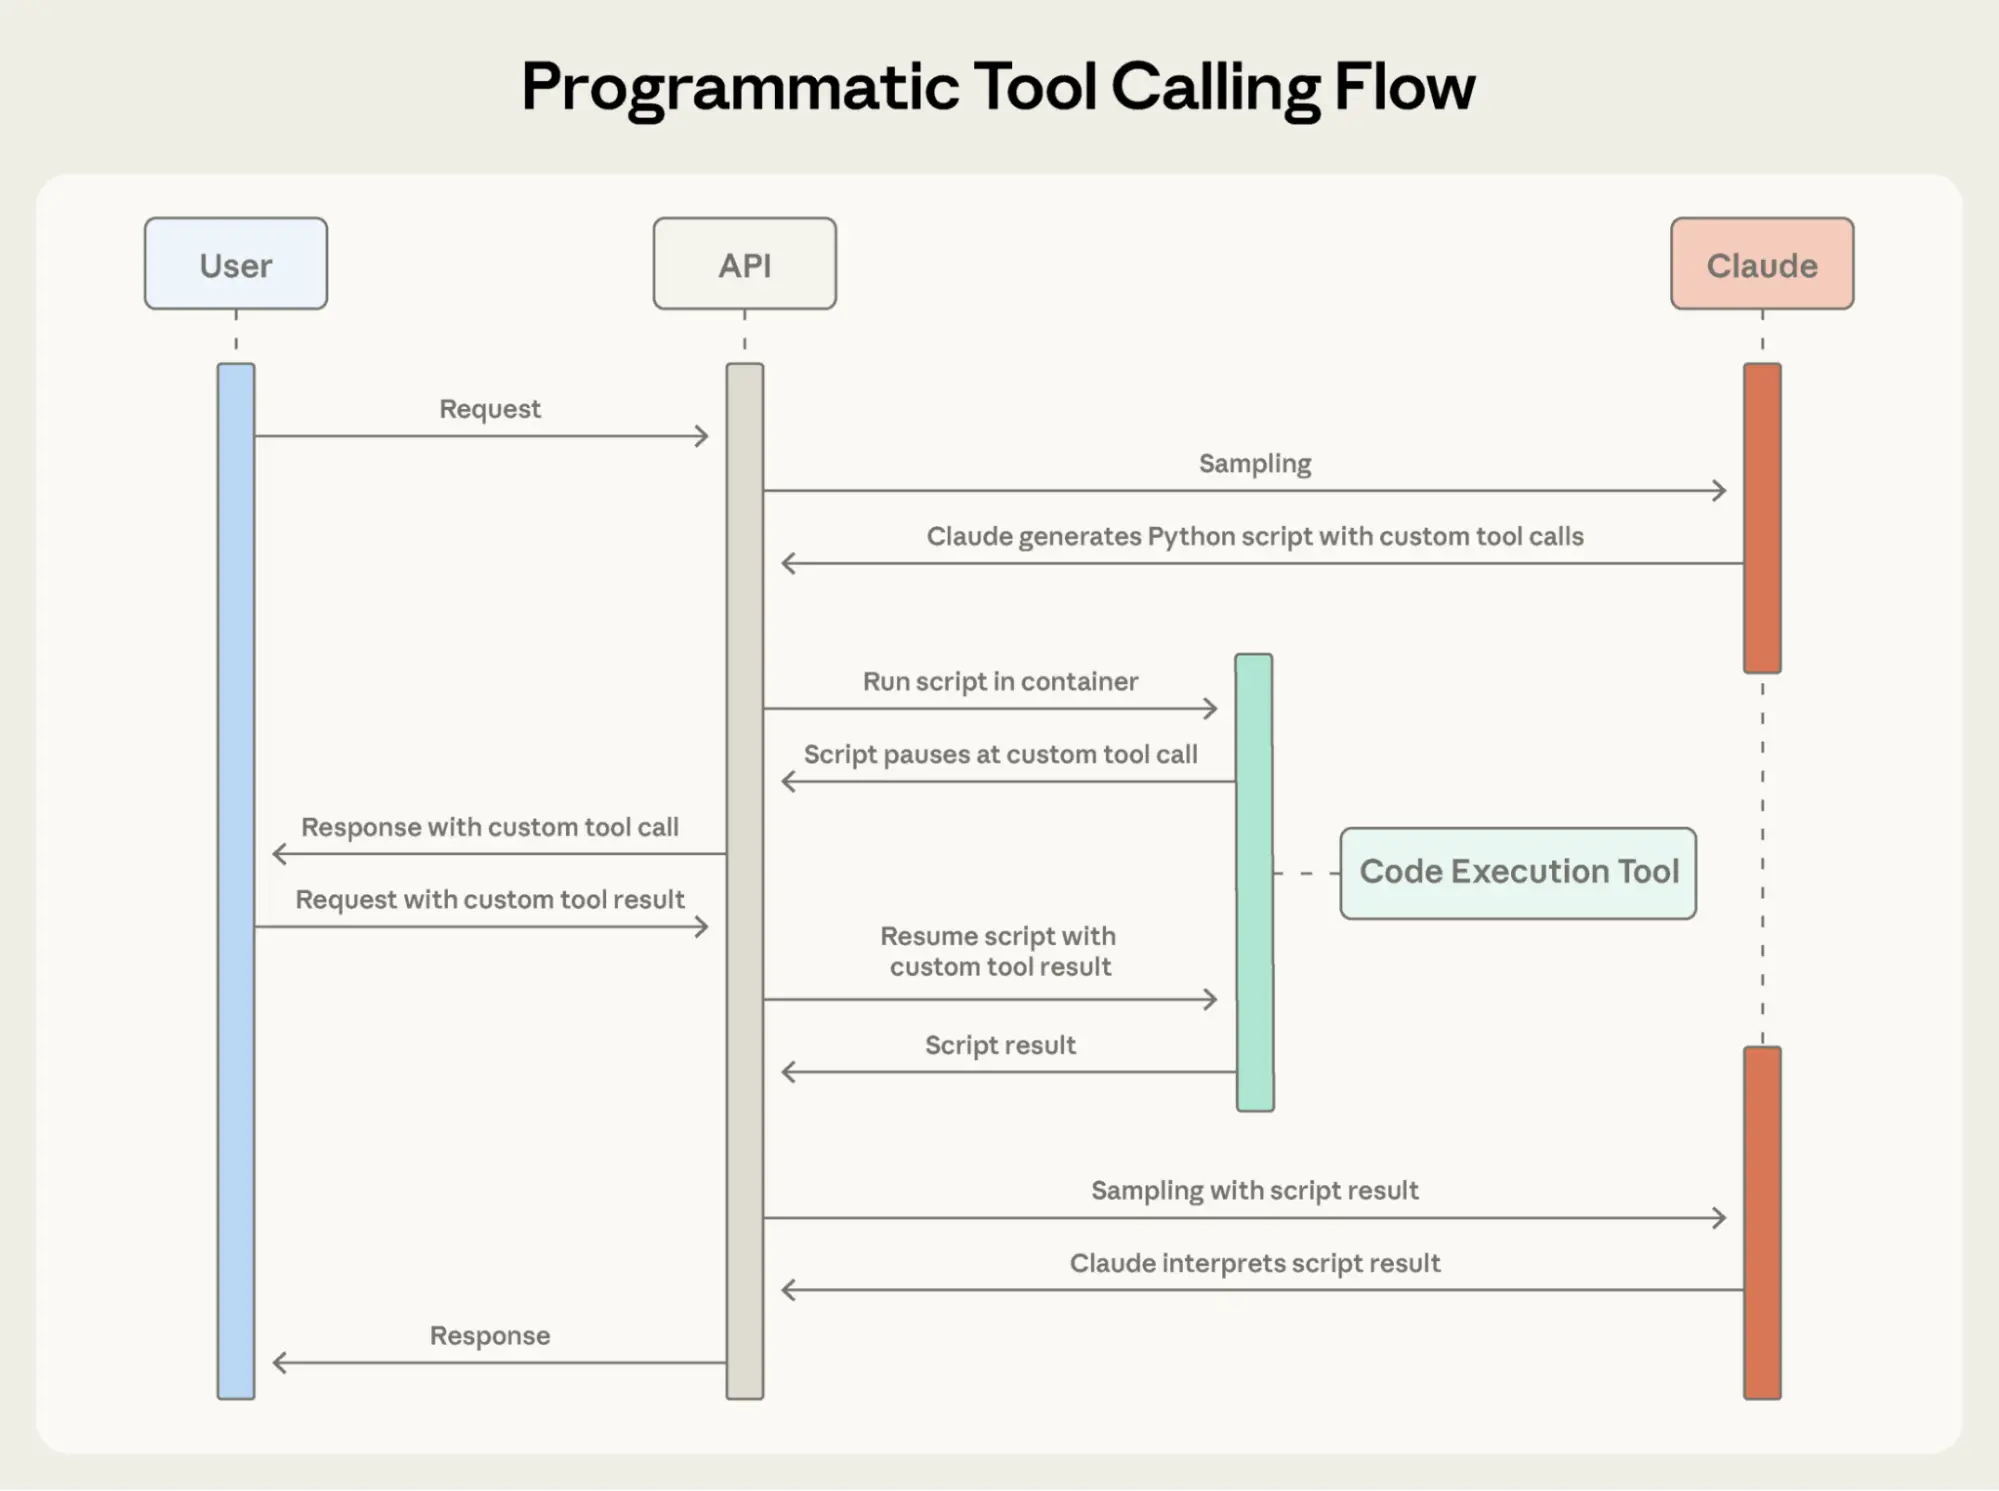
以下是 Claude 在预算合规任务中的编排代码示例:
team = await get_team_members("engineering")

# Fetch budgets for each unique level
levels = list(set(m["level"] for m in team))
budget_results = await asyncio.gather(*[
    get_budget_by_level(level) for level in levels
])

# Create a lookup dictionary: {"junior": budget1, "senior": budget2, ...}
budgets = {level: budget for level, budget in zip(levels, budget_results)}

# Fetch all expenses in parallel
expenses = await asyncio.gather(*[
    get_expenses(m["id"], "Q3") for m in team
])

# Find employees who exceeded their travel budget
exceeded = []
for member, exp in zip(team, expenses):
    budget = budgets[member["level"]]
    total = sum(e["amount"] for e in exp)
    if total > budget["travel_limit"]:
        exceeded.append({
            "name": member["name"],
            "spent": total,
            "limit": budget["travel_limit"]
        })

print(json.dumps(exceeded))
Claude 的上下文仅接收最终结果:那两三位超出预算的人员。两千多行条目、中间汇总和预算查询都不会影响 Claude 的上下文,从而将原始支出数据从 200KB 的消耗量减少到仅 1KB 的结果数据。
效率提升显著:
- 节省token:通过将中间结果排除在 Claude 的上下文之外,PTC 显著降低了token消耗。在复杂研究任务中,平均使用量从 43,588 个token降至 27,297 个token,减少了 37%。
- 降低延迟:每次 API 往返都需要模型推理(耗时数百毫秒至数秒)。当 Claude 在单个代码块中编排 20 多个工具调用时,您就消除了 19 次以上的推理过程。API 处理工具执行时无需每次都返回模型。
- 提高准确性:通过编写明确的编排逻辑,Claude 比用自然语言处理多个工具结果时犯的错误更少。内部知识检索准确率从 25.6%提升至 28.5%;GIA 基准测试从 46.5%提升至 51.2%。
生产工作流程涉及杂乱的数据、条件逻辑以及需要扩展的操作。程序化工具调用让 Claude 能够以编程方式处理这种复杂性,同时保持对可操作结果的关注,而非原始数据处理。
程序化工具调用的工作原理
1. 将工具标记为可从代码调用
将 code_execution 添加到工具中,并将 allowed_callers 设置为选择加入工具以进行程序化执行:
{
  "tools": [
    {
      "type": "code_execution_20250825",
      "name": "code_execution"
    },
    {
      "name": "get_team_members",
      "description": "Get all members of a department...",
      "input_schema": {...},
      "allowed_callers": ["code_execution_20250825"] # opt-in to programmatic tool calling
    },
    {
      "name": "get_expenses",
 	...
    },
    {
      "name": "get_budget_by_level",
	...
    }
  ]
}
API 将这些工具定义转换为 Claude 可以调用的 Python 函数。
2. Claude 编写编排代码
Claude 不再逐个请求工具,而是直接生成 Python 代码:
{
  "type": "server_tool_use",
  "id": "srvtoolu_abc",
  "name": "code_execution",
  "input": {
    "code": "team = get_team_members('engineering')\n..." # the code example above
  }
}
3. 工具执行无需经过 Claude 的上下文处理
当代码调用 get_expenses() 时,您会收到一个包含调用者字段的工具请求:
{
  "type": "tool_use",
  "id": "toolu_xyz",
  "name": "get_expenses",
  "input": {"user_id": "emp_123", "quarter": "Q3"},
  "caller": {
    "type": "code_execution_20250825",
    "tool_id": "srvtoolu_abc"
  }
}
您提供的结果会在代码执行环境中处理,而非在 Claude 的上下文中处理。对于代码中的每个工具调用,此请求-响应循环都会重复进行。
4. 仅最终输出进入上下文
当代码运行结束时,只有代码的执行结果会返回给 Claude:
{
  "type": "code_execution_tool_result",
  "tool_use_id": "srvtoolu_abc",
  "content": {
    "stdout": "[{\"name\": \"Alice\", \"spent\": 12500, \"limit\": 10000}...]"
  }
}
Claude 只能看到这些,而无法看到处理过程中涉及的 2000 多条费用明细。
何时使用编程式工具调用
编程式工具调用为工作流程增加了代码执行步骤。当节省的令牌数量、延迟改善和准确性提升显著时,这种额外开销是值得的。
Most beneficial when: 最适用场景:
- 处理仅需聚合或摘要的大型数据集
- 运行包含三个或更多依赖工具调用的多步骤工作流
- 在 Claude 查看之前对工具结果进行筛选、排序或转换
- 处理不应让中间数据影响 Claude 推理的任务
- 跨多个项目并行运行操作(例如检查 50 个端点)
Less beneficial when: 在以下情况下效果不佳:
- 执行简单的单工具调用
- 处理需要 Claude 查看并推理所有中间结果的任务
- 运行快速查询并获取简短响应
工具使用示例
挑战
JSON Schema 擅长定义结构——类型、必需字段、允许的枚举值——但它无法表达使用模式:何时包含可选参数、哪些组合有意义,或者您的 API 期望遵循哪些约定。
考虑一个支持工单 API:
{
  "name": "create_ticket",
  "input_schema": {
    "properties": {
      "title": {"type": "string"},
      "priority": {"enum": ["low", "medium", "high", "critical"]},
      "labels": {"type": "array", "items": {"type": "string"}},
      "reporter": {
        "type": "object",
        "properties": {
          "id": {"type": "string"},
          "name": {"type": "string"},
          "contact": {
            "type": "object",
            "properties": {
              "email": {"type": "string"},
              "phone": {"type": "string"}
            }
          }
        }
      },
      "due_date": {"type": "string"},
      "escalation": {
        "type": "object",
        "properties": {
          "level": {"type": "integer"},
          "notify_manager": {"type": "boolean"},
          "sla_hours": {"type": "integer"}
        }
      }
    },
    "required": ["title"]
  }
}
该模式定义了何为有效,但关键问题仍未解答:
- 格式模糊性:
due_date应使用"2024-11-06"、“Nov 6, 2024"还是"2024-11-06T00:00:00Z”? - 标识符规范:
reporter.id是 UUID、“USR-12345"还是仅"12345”? - 嵌套结构用法:Claude 应在何时填充
reporter.contact? - 参数相关性:
escalation.level和escalation.sla_hours与优先级有何关联?
这些模糊之处可能导致工具调用格式错误和参数使用不一致。
我们的解决方案
工具使用示例功能允许您直接在工具定义中提供示例工具调用。您无需仅依赖模式定义,而是向 Claude 展示具体的使用模式:
{
    "name": "create_ticket",
    "input_schema": { /* same schema as above */ },
    "input_examples": [
      {
        "title": "Login page returns 500 error",
        "priority": "critical",
        "labels": ["bug", "authentication", "production"],
        "reporter": {
          "id": "USR-12345",
          "name": "Jane Smith",
          "contact": {
            "email": "[email protected]",
            "phone": "+1-555-0123"
          }
        },
        "due_date": "2024-11-06",
        "escalation": {
          "level": 2,
          "notify_manager": true,
          "sla_hours": 4
        }
      },
      {
        "title": "Add dark mode support",
        "labels": ["feature-request", "ui"],
        "reporter": {
          "id": "USR-67890",
          "name": "Alex Chen"
        }
      },
      {
        "title": "Update API documentation"
      }
    ]
  }
从这三个示例中,Claude 学会了:
- 格式规范:日期使用 YYYY-MM-DD 格式,用户 ID 遵循 USR-XXXXX 格式,标签采用短横线连接式
- 嵌套结构模式:如何构建包含嵌套联系人对象的报告者对象
- 可选参数关联规则:严重错误需包含完整联系信息及紧急升级流程并遵守严格服务等级协议;功能请求需包含报告者信息但无需联系人/升级流程;内部任务仅需标题信息
在我们内部的测试中,工具使用示例将复杂参数处理的准确率从 72%提升至 90%。
何时使用工具使用示例
工具使用示例会增加工具定义的token数量,因此当准确率提升带来的价值超过额外成本时,它们才最具价值。
最适用场景:
- 复杂的嵌套结构,其中有效的 JSON 并不代表正确的使用方式
- 具有许多可选参数和包含模式的重要工具
- 具有特定领域惯例但未在模式中体现的 API
- 相似工具中通过示例说明应使用哪一个(例如,
create_ticket与create_incident)
Less beneficial when: 在以下情况下效果不佳:
- 简单单参数工具,用途一目了然
- Claude 已理解的 URL 或电子邮件等标准格式
- 更适合通过 JSON Schema 约束处理的验证问题
最佳实践
构建能够执行现实世界行动的智能体意味着需要同时处理规模、复杂性和精确性。这三个特性协同工作,以解决工具使用工作流中的不同瓶颈。以下是如何有效结合它们的方法。
战略性分层功能
并非每个智能体都需要为特定任务使用全部三项功能。请从最关键的瓶颈入手:
- 工具定义导致上下文臃肿 → 工具搜索工具
- 大型中间结果污染上下文 → 程序化工具调用
- 参数错误与格式不当的调用 → 工具使用示例
这种聚焦式方法让你能够解决限制智能体性能的具体约束,而不是一开始就增加复杂性。
然后根据需要逐步添加其他功能。它们是互补的:工具搜索工具确保找到合适的工具,程序化工具调用确保高效执行,而工具使用示例确保正确调用。
设置工具搜索工具以提升发现能力
工具搜索会匹配名称和描述,因此清晰、描述性的定义能提高发现准确性。
// Good
{
    "name": "search_customer_orders",
    "description": "Search for customer orders by date range, status, or total amount. Returns order details including items, shipping, and payment info."
}

// Bad
{
    "name": "query_db_orders",
    "description": "Execute order query"
}
添加系统提示指导,让 Claude 了解可用的功能:
You have access to tools for Slack messaging, Google Drive file management,
Jira ticket tracking, and GitHub repository operations. Use the tool search
to find specific capabilities.
将你最常用的三到五个工具保持常驻加载,其余工具按需调用。这样既能确保常用操作的即时访问,又能按需发现其他功能。
设置程序化工具调用以确保正确执行
由于 Claude 通过编写代码来解析工具输出,请明确记录返回格式。这有助于 Claude 编写正确的解析逻辑:
{
    "name": "get_orders",
    "description": "Retrieve orders for a customer.
Returns:
    List of order objects, each containing:
    - id (str): Order identifier
    - total (float): Order total in USD
    - status (str): One of 'pending', 'shipped', 'delivered'
    - items (list): Array of {sku, quantity, price}
    - created_at (str): ISO 8601 timestamp"
}
以下是适用于程序化编排的选配工具:
- 可并行运行的工具(独立操作)
- 支持安全重试的操作(幂等性)
配置工具使用示例以确保参数准确性
为行为清晰度设计示例:
- 使用真实数据(真实城市名称、合理价格,而非“字符串”或“数值”)
- 通过最小化、部分和完整规范模式展示多样性
- 保持简洁:每个工具提供 1-5 个示例
- 专注于歧义处理(仅在从模式中无法明确正确用法时添加示例)