pi 是一个开源的 AI coding agent。对于用户而言,它表现为一个能持续对话、自动使用工具、处理错误的命令行助手;对于代码而言,这一切都由 AgentSession 这个类统一调度。
本文通过阅读 AgentSession 的源码,拆解它的四个核心机制:
prompt()处理流程:用户输入如何经过多层预处理后抵达 LLM- 消息事件处理链路:LLM streaming 期间事件如何流转、驱动上层组件
- 自动重试机制:临时性 LLM 错误如何被透明地重试
- 上下文压缩(Compaction):长会话如何在不中断的前提下腾出 context 空间
prompt() 函数处理流程
prompt() 是 AgentSession 的核心入口,负责把用户输入经过一系列处理后发送给 LLM。
主流程:
flowchart TD
    A([prompt]) --> B["① Extension Command 拦截<br/>/xxx → 执行后返回"]
    B -- 未命中或跳过 --> C["② Extension input 事件<br/>可拦截或变换输入"]
    C -- handled 返回 --> Z1([返回])
    C -- 继续 --> D["③ Skill / Template 展开<br/>/skill:name、/template"]
    D --> E{agent 正在 streaming?}
    E -- 是 --> F["④ 排队:steer 或 followUp"]
    F --> Z2([返回])
    E -- 否 --> G["⑤ 校验 model + API key"]
    G -- 失败 --> Z3([抛出错误])
    G -- 通过 --> H["⑥ Compaction 检查"]
    H --> I["⑦ 构建 messages<br/>user + images + pendingNextTurn"]
    I --> J["⑧ Extension before_agent_start 事件<br/>注入 custom messages / 修改 system prompt"]
    J --> K["⑨ agent.prompt + waitForRetry"]
    K --> Z4([返回])
阶段 1:Extension Command 拦截
输入以 / 开头时,优先在 extension runner 里查找注册的命令并执行。Extension command 通过 ctx(即 sendUserMessage())自行决定是否与 LLM 交互,执行完直接返回,不走后续流程。
阶段 2:Extension input 事件
串行通知所有注册了 input 事件的 extension,每个 handler 可以返回:
handled:完全接管,prompt()立即返回transform:修改 text/images,链式传给下一个 extensioncontinue:不做处理,继续
此阶段在 skill/template 展开之前,extension 拿到的是用户原始输入。
阶段 3:Skill / Prompt Template 展开
/skill:name args→ 读取 SKILL.md 文件,包在<skill>标签里,拼上参数,替换原始文本/template args→ 按 prompt template 定义展开
展开后的长文本才是真正发给 LLM 的内容。expandPromptTemplates: false 时跳过阶段 1、2、3,用于 extension 内部调用 sendUserMessage() 时绕过所有用户输入预处理。
阶段 4:Streaming 排队 agent 正在 streaming 时不能直接发送,必须显式声明意图:
steer:打断当前 streaming,插入新消息followUp:等当前 turn 结束后再发
未传 streamingBehavior 直接抛错,强制调用方明确意图。
阶段 5:前置校验 依次校验 model 是否已选择、API key 是否存在(区分 OAuth 和普通 key,给出不同错误提示)。
阶段 6:Compaction 检查 发送前检查 context 是否需要压缩(上一个 response 被中断时 context 可能接近上限)。
阶段 7:构建消息数组
组装本次 turn 的消息:用户文本 + 图片 + _pendingNextTurnMessages(其他机制附加的上下文消息,发完即清空)。
阶段 8:Extension before_agent_start 事件
LLM 调用前的最后一个钩子,extension 可以:
- 注入 custom message(多个 extension 结果累加)
- 修改 system prompt(多个 extension 链式叠加,每次 turn 结束后重置回 base,防止泄漏到下一次 turn)
阶段 9:发送 + 重试
调用底层 agent.prompt(messages) 发送给 LLM,然后 waitForRetry() 等待重试完成后才返回。重试机制的细节见第三节。
消息事件处理链路
prompt() 把请求发出去之后,LLM 的响应以事件流的形式返回。本节拆解这条事件流是如何在 AgentSession 内部流转的。
整体架构
AgentSession 是底层 Agent 和所有上层组件之间的中间层。两者的连接点在构造函数的这一行:
this._unsubscribeAgent = this.agent.subscribe(this._handleAgentEvent);
这行代码把底层 Agent 产生的所有事件接入 AgentSession,驱动上层的所有逻辑。没有它,AgentSession 的所有组件都收不到任何消息。
底层 Agent(只负责和 LLM 通信,产生 AgentEvent)
    ↕  构造函数中的 subscribe
AgentSession
    ├── extension 系统
    ├── session 持久化
    ├── retry / compaction
    └── 外部 listeners(UI、print、rpc)
事件流动链路
底层 Agent streaming 时不断产生 AgentEvent,每个事件的处理路径:
agent.prompt() 执行中,LLM streaming
  → 产生 AgentEvent(agent_start / message_start / message_update / message_end / agent_end 等)
  → 同步触发 AgentSession._handleAgentEvent
      → _createRetryPromiseForAgentEnd(agent_end 时同步创建 retry promise,不能异步)
      → 事件入队 _agentEventQueue(Promise 串行链,保证处理顺序)
          → _processAgentEvent(event)
              → [message_start + user] 从 steering/followUp 队列移除(UI 状态同步)
              → _emitExtensionEvent → 通知 extension 系统
              → _emit → 遍历 _eventListeners,通知所有外部 listener
              → [message_end] session 持久化(写文件)
                  → 记录 _lastAssistantMessage
                  → 成功响应时重置 retry 计数器
              → [agent_end]
                  → 可重试错误?→ _handleRetryableError → 重试,return
                  → _resolveRetry()(解除 prompt() 里 waitForRetry 的等待)
                  → _checkCompaction(检查是否需要自动压缩 context)
_agentEventQueue 串行队列
_agentEventQueue 初始值是 Promise.resolve(),每个事件到来时追加到链尾:
this._agentEventQueue = this._agentEventQueue.then(
    () => this._processAgentEvent(event),  // 前一个成功时执行
    () => this._processAgentEvent(event),  // 前一个失败时也执行
);
两个回调传同一个函数,目的是:无论前一个事件处理成功还是失败,当前事件都必须被处理。如果只传一个 onFulfilled,任何一个事件处理抛异常都会导致整个队列死掉,后续事件永远不会被处理。
外部 listener 的注册与触发
外部通过 subscribe() 注册 listener,存入 _eventListeners 数组:
const unsubscribe = session.subscribe((event) => {
    // 处理事件
});
_emit() 遍历 _eventListeners 挨个调用,各模式做各自的事:
- interactive mode:更新 TUI,渲染 streaming token、tool call 结果
- print mode:json 模式输出事件流;text 模式等
agent_end后输出最终结果 - rpc mode:序列化事件,通过 IPC 发给调用方
值得注意的是:即使外部不调用 subscribe(),AgentSession 内部的持久化、extension、retry、compaction 逻辑也会正常运行,因为它们都在 _processAgentEvent 里,由内部永久订阅驱动。
自动重试机制
LLM 调用并不总是成功的。rate limit、服务过载、网络抖动等临时性错误随时可能发生。本节介绍 AgentSession 如何对调用方透明地处理这些错误。
设计目标
prompt() 最终要等到重试成功或彻底放弃后才返回——调用方不感知中间的重试过程。
核心:用 Promise 作为锁
重试期间 prompt() 不能返回,否则调用方会误以为请求已经完成。实现方式是用一个 Promise 作为锁:
// 创建锁
this._retryPromise = new Promise((resolve) => {
    this._retryResolve = resolve;  // 把 resolve 存起来,留着开锁用
});

// prompt() 末尾等待锁打开
await this.waitForRetry();  // → await this._retryPromise

// 重试完成后开锁
this._retryResolve();  // _retryPromise 变为 fulfilled,waitForRetry() 解除
锁必须同步创建
agent.prompt() 内部,LLM 返回错误时会同步 emit agent_end 事件,然后才返回。时序如下:
LLM 返回错误
    → agent 同步 emit agent_end
        → _handleAgentEvent 同步执行
            → _createRetryPromiseForAgentEnd → 创建锁(同步!)
            → 事件入队(异步,还没执行)
    → agent.prompt() 返回
prompt() 调用 waitForRetry()
    → _retryPromise 已存在,await 住
如果锁在队列里异步创建,waitForRetry() 被调用时锁还不存在,prompt() 会直接返回,重试还没开始。所以 _createRetryPromiseForAgentEnd 必须在 _handleAgentEvent 里同步执行,不能放进 _agentEventQueue。
触发重试的条件
_isRetryableError 判断是否可重试:
stopReason === "error"且有errorMessage- 不是 context overflow(那个由 compaction 处理)
- 错误信息匹配:overloaded、rate limit、429/500/502/503/504、network error、timeout 等
重试执行过程(_handleRetryableError)
1. 检查次数:_retryAttempt > maxRetries?
       是 → 发 auto_retry_end(success: false) → 开锁 → 返回 false

2. 计算退避时间:baseDelayMs * 2^(attempt-1)
   (第1次 * 1,第2次 * 2,第3次 * 4,指数增长)

3. 发 auto_retry_start 事件(UI 显示"正在重试...")

4. 从 agent state 删除错误的 assistant 消息
   (保留在 session 文件里供历史查看,但不能带进重试的上下文)

5. sleep(退避时间)(可被 abortRetry() 中断)

6. setTimeout(() => agent.continue(), 0)  ← 触发重试
   用 setTimeout 跳出当前事件处理链,避免在队列中嵌套新的 agent 执行

7. 返回 true(已发起重试,_processAgentEvent 跳过 compaction 检查)
重试成功后
agent.continue() 触发新一轮 LLM 请求,产生新的 AgentEvent。若成功,新的 agent_end 到来时:
// _processAgentEvent(agent_end)
this._resolveRetry();  // 开锁
await this._checkCompaction(msg);
锁打开,waitForRetry() 解除,prompt() 返回。
若再次失败,再走一遍 _handleRetryableError,直到成功或超过最大次数。
完整时序
agent.prompt() → LLM 返回错误
    → [同步] _createRetryPromiseForAgentEnd → 创建锁
    → agent.prompt() 返回

prompt() → waitForRetry() → await 锁(被阻塞)

[队列] _processAgentEvent(agent_end)
    → _handleRetryableError
        → 删错误消息 → sleep → setTimeout(agent.continue())
        → return true(不做 compaction)

agent.continue() → 新一轮 LLM 请求...
    → 成功 → agent_end → _resolveRetry() → 锁打开
    → 失败 → 再次走 _handleRetryableError

锁打开 → waitForRetry() 解除 → prompt() 返回
上下文压缩(Compaction)
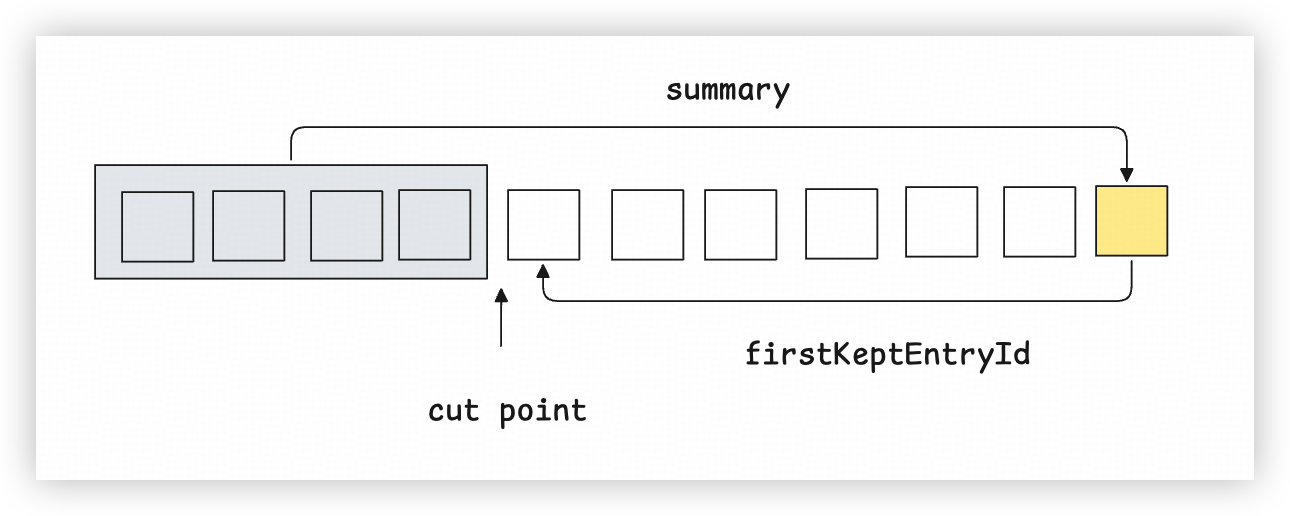
LLM 的 context window 是有限的。下面是 Compaction 的整体数据流:
设计目标
长时间的 coding session 里,历史消息会不断积累,最终撑满窗口导致后续请求失败。Compaction 的目标是:在不中断会话的前提下,把旧的对话历史「总结」掉,只保留最近的一段原始消息,从而腾出空间继续对话。
触发时机
在 prompt() 的阶段 6,以及每次 agent_end 之后,都会调用 _checkCompaction() 检查是否需要压缩。
触发条件(shouldCompact):
当前 context token 数 > contextWindow - reserveTokens
默认 reserveTokens = 16384,即 context 快被填满(留 16k 缓冲区)时触发。
Token 数量估算(estimateContextTokens)
并非每条消息都有精确 token 数。算法的策略是:
- 找到最近一条成功的 assistant 消息,它的
usage字段里有精确 token 数 - 对该消息之后(还未得到 LLM 反馈)的消息,用
estimateTokens估算
estimateTokens 用字符数 / 4 粗略估算,图片估算为 1200 token(4800 字符)。这对英文比较准,中文一个字符可能对应 1-3 个 token,存在低估风险。
切割点选取(findCutPoint)
这是算法的核心,决定从哪里开始丢弃历史。
目标:保留最近约 keepRecentTokens(默认 20000 token)的原始消息,其余的全部总结掉。
算法:从最新消息向前遍历,累加 token 估算值,累计超过 keepRecentTokens 时停下,在当前位置找最近的合法切割点。
合法切割点的限制:只能切在 user / assistant / custom / bashExecution 消息上,不能切在 toolResult。因为 toolResult 在 LLM 视角里必须紧跟在对应的 toolCall 之后,单独保留 toolResult 而丢弃其 toolCall 会产生非法消息序列。
找到切割点后,还要处理切割点前的非消息条目(配置变更等),并判断是否落在 turn 中间(isSplitTurn)。
Split Turn 处理
如果切割点不是一个 user 消息的开头,说明切割点落在了某轮对话的中间——例如:
[user] 请帮我重构这个函数          ← turn 开始
[assistant] 好的,我来分析...      ← 切割点落在这里
[toolCall] read_file(...)
[toolResult] ...
[assistant] 分析完了,开始修改     ← 这里才是最终保留的起点
此时 isSplitTurn = true,算法会把这轮对话拆成两部分:
messagesToSummarize:切割点之前的所有历史(含本轮之前的部分)→ 总结后丢弃turnPrefixMessages:本轮对话中被丢弃的前半段 → 单独生成一个 “turn prefix summary”
两个 summary 并行生成,拼接后作为最终摘要的一部分。
摘要生成(generateSummary)
用 LLM 本身来生成摘要。先把待总结的消息序列化成纯文本,然后用结构化 prompt 要求输出固定格式:
## Goal
## Constraints & Preferences
## Progress(Done / In Progress / Blocked)
## Key Decisions
## Next Steps
## Critical Context
增量更新:如果这不是第一次压缩(session 已有历史摘要),则用 UPDATE_SUMMARIZATION_PROMPT 把新消息的信息 merge 进旧摘要,而不是从头重写。这样多轮压缩后,摘要始终是一个完整的「项目快照」,不会因为叠加而丢失早期信息。
文件操作追踪
Compaction 还会额外追踪 session 中所有 read / write / edit 过的文件,追加到摘要末尾:
## Files Read
- src/foo.ts
## Files Modified
- src/bar.ts
这些信息来自两个来源:
- 上一次 compaction 的
details字段(持久化在 session 文件里) - 当前段落里的 tool call 参数(从消息中提取)
两者合并,保证每次压缩都能传递完整的文件操作历史。
完整压缩流程
_checkCompaction()
    → prepareCompaction()
        → 找到上次 compaction 的边界(prevCompactionIndex)
        → estimateContextTokens → 计算当前 token 数
        → findCutPoint → 找切割点
        → 分离 messagesToSummarize / turnPrefixMessages
        → extractFileOperations → 收集文件操作历史
    → compact(preparation)
        → isSplitTurn?
            是 → 并行生成 historySum + turnPrefixSum → 拼接
            否 → 生成 historySum
        → 追加 Files Read / Files Modified
        → 返回 CompactionResult { summary, firstKeptEntryId, tokensBefore }
    → SessionManager 保存 compaction 条目到 session 文件
    → 重新加载 session(从 firstKeptEntryId 开始重建消息数组)
压缩完成后,LLM 看到的上下文变为:
[compactionSummary]  ← 结构化摘要(替代全部历史)
[最近 ~20000 token 的原始消息]
关键参数
| 参数 | 默认值 | 含义 |
|---|---|---|
reserveTokens |
16384 | context 窗口预留缓冲区,触发压缩的阈值 |
keepRecentTokens |
20000 | 保留最近多少 token 的原始消息 |
maxTokens for summary |
reserveTokens * 0.8 |
摘要生成时允许输出的最大 token 数 |
小结
AgentSession 并不直接和 LLM 通信,它做的事是在底层 Agent 之上组织一套完整的调度层:
prompt()流程保证用户输入经过扩展拦截、模板展开、合法性校验等多层处理后才真正发出- 事件处理链路用串行 Promise 队列将底层事件有序地分发给 extension、持久化、外部 listener
- 重试机制用一个同步创建的 Promise 作为锁,让
prompt()对调用方透明地等待重试完成 - Compaction在 context 快撑满时用增量摘要替代历史,让长会话得以持续
四个机制相互配合,共同支撑了 pi 作为 coding agent 的核心用户体验:即使面对长对话、LLM 故障、并发输入,会话依然能平稳推进。